آغاز کار با شبکههای عصبی: طبقهبندی و رگرسیون
مقدمه این فصل برای شروع استفاده شما از شبکههای عصبی برای حل مسائل واقعی طراحی شده است. شما دانش کسبشده از فصلهای ۲ و ۳ را تثبیت خواهید کرد و آنچه را که آموختهاید در سه کار جدید که سه مورد استفاده رایج شبکههای عصبی را پوشش میدهند، به کار خواهید گرفت—طبقهبندی دودویی، طبقهبندی چندکلاسه، […]
مقدمهای بر کراس (Keras) و تنسورفلو(Tensor Flow)
مقدمه این فصل قصد دارد هر آنچه برای شروع یادگیری عمیق در عمل نیاز دارید را به شما بدهد. من یک ارائه سریع از Keras (https://keras.io) و TensorFlow (https://tensorflow.org)، ابزارهای یادگیری عمیق مبتنی بر پایتون که در سراسر کتاب از آنها استفاده خواهیم کرد، خواهم داشت. خواهید فهمید که چگونه یک فضای کاری یادگیری عمیق […]
بخشهای سازنده ریاضی شبکههای عصبی
مقدمه برای درک یادگیری عمیق، آشنایی با بسیاری از مفاهیم ریاضی ساده ضروری است: تنسورها، عملیات تنسور، مشتقگیری، گرادیان کاهشی و غیره. هدف ما در این فصل، ساختن شهود شما در مورد این مفاهیم بدون ورود بیش از حد به جزئیات فنی است. به طور خاص، ما از نمادهای ریاضی دوری خواهیم کرد، چرا که […]
یادگیری عمیق چیست
مقدمه در چند سال گذشته، هوش مصنوعی (AI) موضوع تبلیغات رسانهای شدیدی بوده است. یادگیری ماشین، یادگیری عمیق و هوش مصنوعی در مقالات بیشماری، اغلب خارج از نشریات با رویکرد فناوری، مطرح میشوند. به ما آیندهای از چتباتهای هوشمند، خودروهای خودران و دستیاران مجازی وعده داده شده است—آیندهای که گاهی در نور تیره و تار […]
یادگیری عمیق در مقابل یادگیری ماشین: تفاوتهای کلیدی که باید بدانید!

مقدمه در دنیای هوش مصنوعی، دو اصطلاح یادگیری ماشین (Machine Learning) و یادگیری عمیق (Deep Learning) بیش از هر زمان دیگری شنیده میشوند. بسیاری از افراد این دو مفهوم را بهجای یکدیگر استفاده میکنند، در حالی که تفاوتهای مهمی میان آنها وجود دارد؛ تفاوتهایی که دانستن آنها برای انتخاب روش درست در هر پروژه دادهمحور […]
آموزش جامع یادگیری عمیق (Deep Learning)-بخش اول

مقدمه در سالهای اخیر، پیشرفت هوش مصنوعی باعث شده است سیستمهایی ساخته شوند که بتوانند تصویر را تشخیص دهند، متن تولید کنند، صدا را درک کنند و حتی تصمیمهای پیچیده بگیرند. پشت بسیاری از این قابلیتها، مفهومی به نام یادگیری عمیق(Deep Learning) قرار دارد. رویکردی پیشرفته که تحولی جدی در دنیای یادگیری ماشین ایجاد کرده […]
تکنیکهای انتخاب ویژگی در یادگیری ماشین (Feature Selection Techniques)
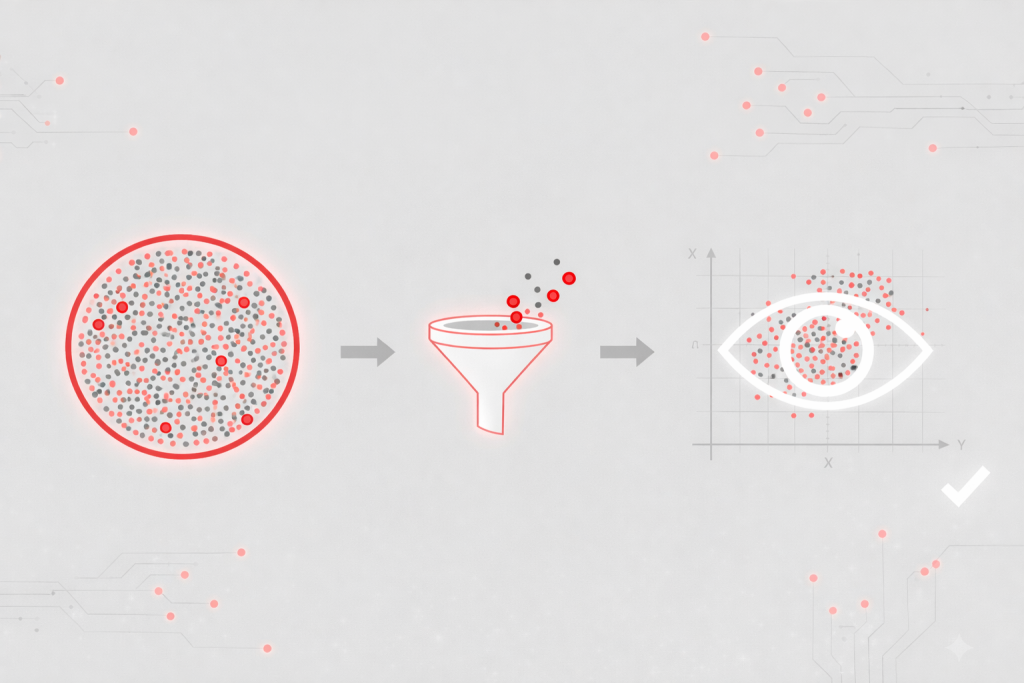
مقدمه در پروژههای یادگیری ماشین، همیشه «دادهی بیشتر» به معنای «مدل بهتر» نیست. در بسیاری از مواقع، وجود ویژگیهای زیاد، نامرتبط یا تکراری نهتنها کمکی به بهبود مدل نمیکند، بلکه باعث افزایش پیچیدگی، کاهش دقت و افت توان تعمیمپذیری میشود. اینجاست که انتخاب ویژگی (Feature Selection) بهعنوان یکی از مهمترین مراحل پیشپردازش دادهها مطرح میشود. […]
قسمت 5: استراتژیهای مدیریت (حذف، اصلاح یا نگهداری؟)
مقدمه شناسایی دادههای پرت فقط نیمی از مسیر است؛ تصمیمگیری درباره اینکه با این نقاط چه رفتاری داشته باشیم، بخش حساستر و تعیینکنندهتر ماجراست. یک انتخاب اشتباه—مثل حذف همه دادههای پرت—میتواند تحلیلها را منحرف کند، دقت مدلها را کاهش دهد یا حتی بخش مهمی از واقعیت داده را از بین ببرد.در این بخش به مهمترین […]
جعبهابزار تشخیص دادههای پرت (بخش اول): روشهای آماری، مقاوم و خوشهبندی
1.مقدمه تشخیص دادههای پرت یکی از حساسترین مراحل تحلیل داده و یادگیری ماشین است. انتخاب روش مناسب، مستقیم بر کیفیت مدل، دقت تحلیل و حتی تصمیمهای نهایی اثر میگذارد. اما مسئله فقط پیدا کردن چند مقدار عجیب نیست؛ بلکه انتخاب صحیح روش بر اساس نوع داده، فرضهای آماری، محدودیتهای محاسباتی و هدف نهایی پروژه است.در […]
جعبهابزار تشخیص دادههای پرت (بخش دوم): روشهای پیشرفته و هوشمند
مقدمه پس از بررسی روشهای سنتی تشخیص دادههای پرت — از جمله آماری، غیرپارامتریک، فاصلهای و خوشهبندی — به سراغ ابزارهای پیشرفته میرویم، چون در دنیای واقعی دادهها اغلب چندبعدی، حجیم، پیچیده یا دارای وابستگیهای زمانی هستند و در چنین شرایطی، روشهای کلاسیک دیگر پاسخگو نیستند؛ درنتیجه نیاز به مدلهای هوشمندِ مبتنی بر یادگیری ماشین […]